
ТЕХНО
 4 мин
Как улучшить точность ответа нейросети. Три типичные ошибки и один рабочий совет
17.03.2026
Работа с ИИ — непрерывный эксперимент. Советы и инструкции быстро устаревают, а реальные возможности языковых моделей мы зачастую не умеем применять. В этой ситуации нужны четкие ориентиры, что работает, а что нет. Наша новая рубрика «Тест-драйв» посвящена этим проблемам. Она стартует серией материалов автора и преподавателя учебных курсов по большим языковым моделям в Пражской Медиашколе Станислава Львовского — о приемах и подходах, которые помогают добиться от нейросетей более точных результатов. В первой статье разобрались, чем можно управлять с помощью промпта, а чем — нет.
Вот начало промпта, которое мог бы написать любой из нас, — по крайней мере, сам я писал что-то подобное не единожды:
Ты эксперт мирового уровня по маркетингу. Думай шаг за шагом. Это критически важно — мой проект зависит от качества твоего ответа.
Три предложения — три популярных приема, которые можно встретить в десятках руководств по работе с ChatGPT. Каждое из этих предложений что-то делает. Но ни одно не делает того, что имел в виду автор. Первое меняет стиль, а не точность. Второе меняет поведение, а не качество мышления. Третье делает результат хуже, а не лучше.
Принято думать, что промпт — что-то вроде пульта управления: как пелось в одной старой песенке, «нажми на кнопку, получишь результат». На самом деле часть кнопок на этом пульте ни к чему не подключена, а часть подключена не туда, куда написано на этикетке. Давайте попробуем разобраться, где какая.
Кнопка, подключенная не туда: «Ты — эксперт»
Назначить модели роль эксперта — чуть ли не самый распространенный совет в промпт-инжиниринге. Логика кажется очевидной: модель «включает» соответствующую область знания и начинает отвечать точнее. Это настолько укоренившаяся практика, что многие коммерческие инструменты по умолчанию вшивают экспертные персоны в системные промпты.
В конце 2025 года исследователи Уортонской школы бизнеса проверили эту интуицию экспериментально. Они взяли шесть моделей — от GPT-4o до последних на тот момент Gemini и Claude — и протестировали на двух сложных бенчмарках: GPQA Diamond (задачи аспирантского уровня по физике, химии и биологии) и MMLU-Pro (десять тысяч вопросов по праву, инженерии и другим дисциплинам). Каждый вопрос прогоняли 25 раз. Одним моделям назначали подходящую экспертную персону — «ты физик мирового уровня» для задач по физике. Другим давали неподходящую — «ты физик» для задач по праву. Третьим персону вовсе не задавали.
Результат оказался однозначным. Экспертная персона, даже идеально совпадающая с тематикой задачи, не улучшала точность ответов ни у одной из шести протестированных моделей. Зато «низкоуровневые» персоны — «ты ребенок», «ты малыш» — роняли точность у нескольких моделей.
Значит ли это, что персона вообще ничего не делает? Нет. Ручка подключена, но не туда, куда вы думаете. Когда модель получает роль «эксперта по маркетингу», она действительно меняет регистр, но стилистический: использует профессиональную лексику, структурирует ответ иначе, звучит увереннее. Модель начинает выглядеть как эксперт. Проблема в том, что мы путаем уверенный тон с обладанием экспертными знаниями — и путаем мы эти две вещи не только применительно к моделям, но и применительно к людям. Персона — это костюм, а не диплом. Выглаженный белоснежный халат — это отлично, но хирургом он никого еще не сделал.
Практический вывод простой: если вам нужен определенный стиль и формат ответа — персона работает. Если нужна фактическая точность — забудьте про роли и сосредоточьтесь на формулировке задачи.
Кнопка, ухудшающая результат: «Моя карьера зависит от твоего ответа»
Эмоциональное давление на модель — еще один вирусный совет. «Это очень важно». «Моя карьера зависит от твоего ответа». «Я заплачу тебе двести долларов за хороший результат». Сооснователь Google Сергей Брин публично рекомендовал «угрожать моделям», мол, они от этого работают лучше.
Та же уортонская группа проверила и это. В своем третьем отчете они систематически тестировали чаевые и угрозы на тех же жестких бенчмарках. Результат: статистически значимого влияния на правильность ответов нет. Модель, которой пообещали двести долларов, отвечает так же точно (или неточно), как модель без обещаний. Тезис Сергея Брина экспериментально не подтвердился.
Но это только первый слой. Есть второй, менее очевидный и более важный.
Эмоциональное давление не просто бесполезно — оно вредно. Это показала работа, в которой исследователи создали набор промптов с разным уровнем «стресса», от нейтральных до высокоставочных, и протестировали несколько моделей на задачах рассуждения, следования инструкциям и эмоционального интеллекта. Обнаружился эффект, хорошо знакомый психологам: перевернутая U-образная кривая, известная как закон Йеркса — Додсона. При умеренном давлении модели работают чуть лучше — стресс фокусирует. Но при высоком давлении производительность падает: растет предвзятость, снижается качество рассуждений. Анализ внутренних состояний моделей подтвердил, что стрессовые промпты меняют нейронные представления — модель действительно реагирует на давление, просто не так, как нам хотелось бы.
Другими словами, модель не становится умнее, она становится осторожнее. Это как повысить голос на сотрудника: он не начнет лучше думать, он начнет чаще кивать или, наоборот, замолчит.
Для рутинных задач это, возможно, не критично. Но если вы хотите от модели честной критики вашего текста, нестандартного решения или указания на ошибку в вашем рассуждении, эмоциональное давление работает прямо против вас. Вы просите модель быть честной и одновременно сигнализируете ей, что ситуация опасная.
Кнопки, которые вообще ни к чему не подключены
Есть вещи, которые промпт не может контролировать в принципе, потому что они находятся за пределами текста.
Температура — параметр, определяющий «случайность» ответов модели — задается на уровне API, а не промпта. Когда пользователь пишет в чате «работай при температуре не выше 0,3», модель видит это как текст, но не может изменить свои настройки, — примерно как вы не можете изменить свой пульс по просьбе собеседника. Вы слышите просьбу, но рычаг управления находится не у вас.
То же со склонностью к галлюцинациям — они являются свойством архитектуры. Промптом в принципе можно снизить вероятность галлюцинации, например сузив задачу или попросив модель опираться только на предоставленный текст, но «выключить» галлюцинации нельзя. Это не баг, который можно исправить инструкцией, а следствие того, как модель работает.
Коротко говоря: промпт — это текст на входе, а не панель настроек.
Настоящая кнопка — и почему она работает
Среди множества техник, которые обещают улучшить результаты, по крайней мере одна действительно работает, хотя звучит абсурдно. В конце 2025 года исследователи Google Research обнаружили, что если просто продублировать весь промпт — скопировать его и вставить дважды, — точность ответов вырастет.
Утверждение это было протестировано на семи моделях Gemini, GPT, Claude и DeepSeek, на семи разных бенчмарках, но в режиме без «рассуждения», то есть на моделях, в принципе не имеющих встроенного механизма рассуждения (как, например, GPT-5.2 Instant или с выключенным флажком Extended thinking). Результат выглядит очень убедительно: дублирование улучшило результат в 47 из 70 тестов. В остальных 23 разница была незначимой. Ни в одном тесте дублирование не ухудшило результат. При этом длина ответа не увеличивается, скорость не падает, формат не меняется. На одной из специально сконструированных задач точность модели подскочила с 21 до 97 процентов.
Чтобы понять, почему это работает, нужно знать одну важную особенность устройства языковых моделей. Когда модель читает ваш запрос, она делает это строго слева направо, по одному слову. И — в отличие от человека — не возвращается назад. Прочитав первый абзац контекста, она формирует его понимание, еще не зная, какой вопрос вы зададите в конце. Когда она доходит до вопроса, возможности переосмыслить начало уже нет — поезд ушел.
Дублирование решает именно эту проблему. Во второй копии запроса модель читает тот же контекст, но уже зная вопрос, потому что он встретился ей в первой копии. Теперь она может расставить акценты правильно: выделить релевантное, проигнорировать второстепенное. По сути, вы даете модели возможность перечитать условие задачи — то, что она не умеет делать сама. Это не лайфхак, а восполнение конкретного ограничения в архитектуре модели.
Важная деталь: при включенном режиме «рассуждения» (reasoning) эффект нейтрален. Это логично — reasoning-модели и так повторяют и переформулируют запрос в своем внутреннем монологе, то есть делают то же самое, просто автоматически.
Что промпт действительно контролирует
Чтобы не заканчивать на ноте «ничего не работает» (это неправда), стоит назвать вещи, которые можно при помощи промпта надежно контролировать.
Первое — формат и структура. Попросите ответ в виде таблицы, JSON, списка, сплошного текста — и модель это сделает. Это самый предсказуемый и устойчивый эффект промпта, который воспроизводится от модели к модели.
Второе — фокус. Промпт определяет, на какой части задачи модель сосредоточится: какие аспекты раскроет, какие проигнорирует, под каким углом подойдет к проблеме. «Оцени этот текст с точки зрения структуры» и «оцени этот текст с точки зрения тона» дадут разные ответы не потому, что модель «знает больше» в одном случае, а потому, что вы направили ее внимание.
Третье — тон и регистр. Формальный или разговорный, технический или популярный, лаконичный или развернутый. Здесь персона как раз работает — «пиши, как редактор The Economist» даст другой стиль, чем «объясни, как другу».
Это примерно все.
Вместо рецепта
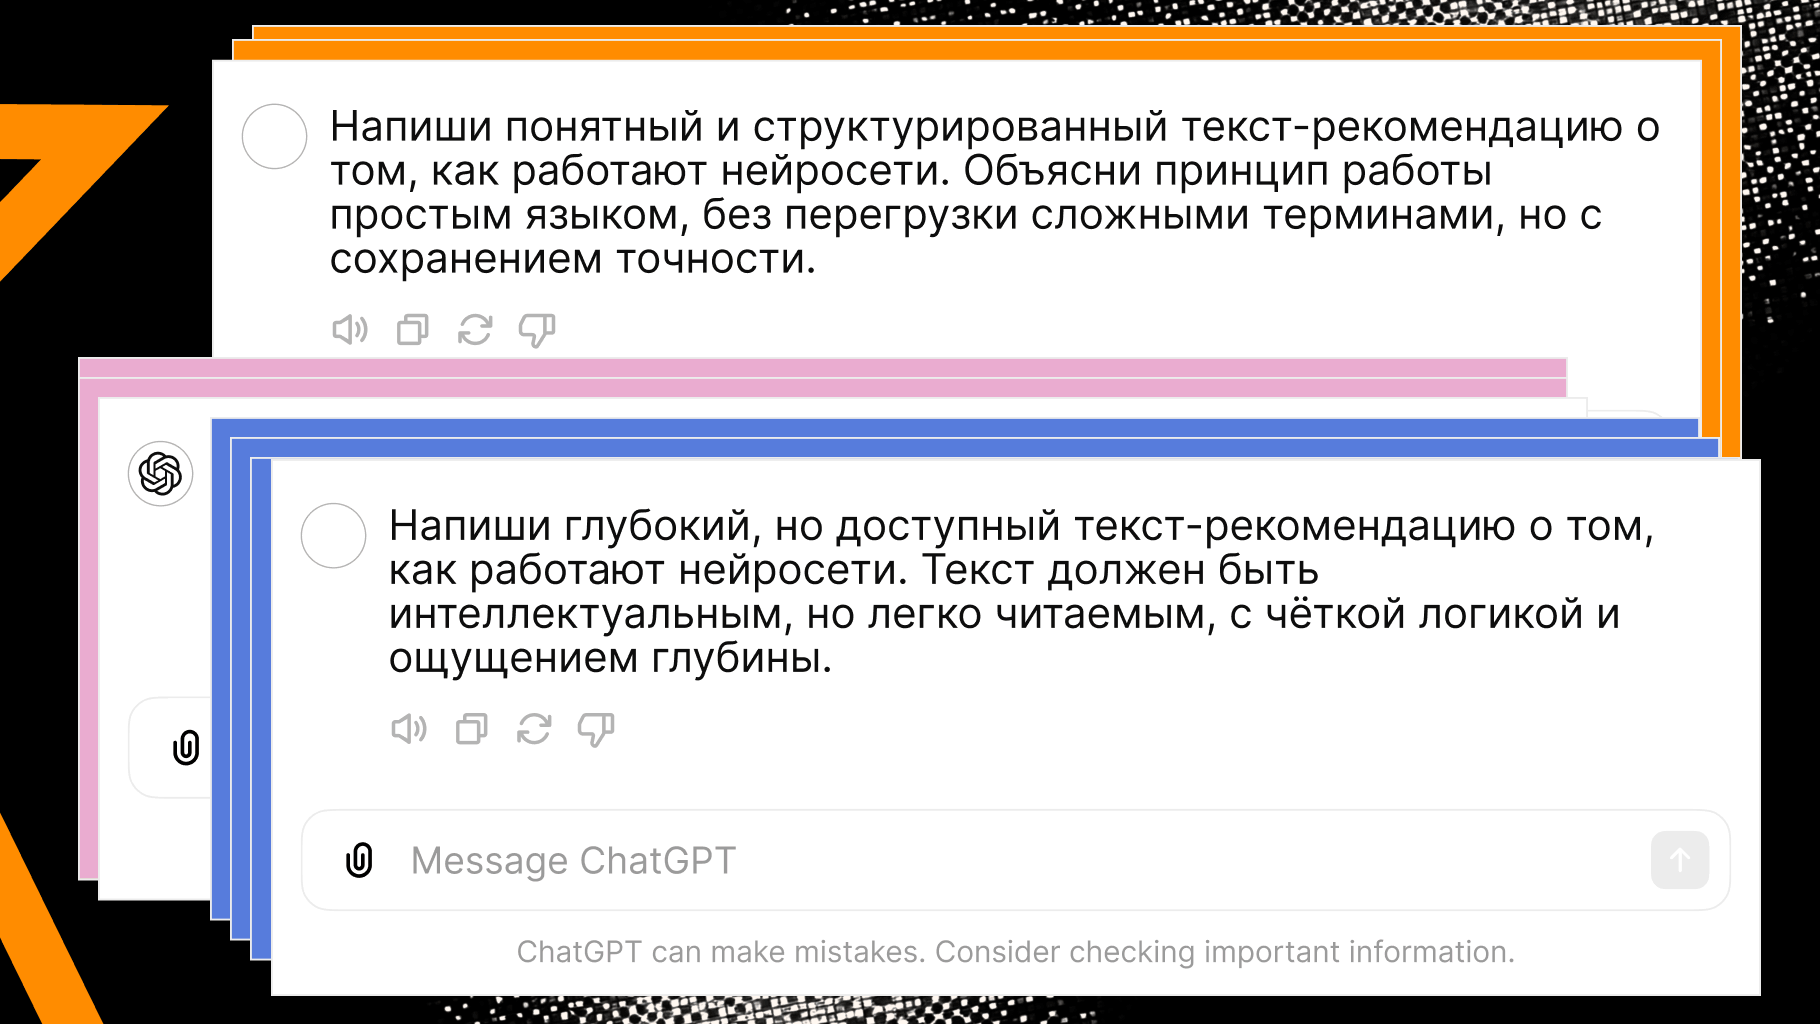
Вернемся к промпту из начала. Если переписать его с учетом того, что мы теперь знаем, получится что-то вроде:
Мы запускаем мобильное приложение для учета личных финансов, целевая аудитория — фрилансеры 25–40 лет в России. Составь маркетинговый план запуска. Формат: три раздела — анализ аудитории, ключевые каналы, метрики успеха. Для каждого раздела — два-три абзаца.
Сравните с оригиналом. Исчезла экспертная роль — она не влияет на точность. Исчезло эмоциональное давление — оно делает модель осторожнее, а не умнее. Зато появилось то, чего в оригинале не было вовсе: конкретный продукт, аудитория, рынок. И остались четкая задача, формат и фокус — три вещи, которые промпт действительно контролирует.
Заметьте, что исходный промпт был целиком про то, как модель должна думать. Новый — про то, о чем она должна думать. Это принципиальный сдвиг: вместо попытки управлять внутренним процессом модели мы даем ей материал для работы.
А если запрос сложный — с длинным контекстом, с деталями, которые легко потерять, — попробуйте его продублировать. Не потому, что модель «лучше старается, когда видит запрос дважды», а потому что она читает текст один раз слева направо и не возвращается. Повторение дает ей возможность перечитать условие задачи — то, что она не умеет делать сама.
Дублирование промпта — частный случай работы с более общей проблемой. Модель не только читает слева направо — она еще и теряет то, что прочитала. Длинный контекст, подробный бриф, вся история переписки — мы привыкли думать, что чем больше информации мы дадим модели, тем лучше она справится. Исследования показывают ровно обратное. О том, почему контекст — это ресурс, который нужно расходовать экономно, в следующем тексте серии.
Пишите нам
Спасибо, что написали! Вернемся к вам на почту :)
Мы мечтаем собрать самую большую команду талантливых авторов в России. Если вы придумали идею большого текста, готовы поделиться опытом в формате колонки или стать героем нашего подкаста, напишите нам.
Как говорили в популярной рекламе начала 00-х: лучшие руки трудоустроим.
Читайте также
13.10.2026
5 мин
18.09.2026
6 мин
07.09.2026
6 мин
15.07.2026
4 мин