
ТЕХНО
 3 мин
Закройте этот чат. Что делать, если модель зацикливается на собственных ответах
07.05.2026
Контекстное окно не заполнено, а модель уже теряет гибкость в рассуждениях, перестает отзываться на инструкции, зацикливается на собственных ответах. Это распространенная ситуация, особенно в работе с текстами. В новом материале своего авторского цикла преподаватель Пражской медиашколы Станислав Львовский рассказывает, как построить работу с нейросетью, чтобы избежать так называемого загрязнения контекста.
Вот, например, автор пишет колонку и хочет опереться на короткое объяснение одного понятия — скажем, чем в экономике инфляция спроса отличается от инфляции предложения. Он открывает чат и спрашивает. Модель отвечает — внятно, с аккуратными примерами, в уверенном учительском тоне, в котором языковые модели обычно ведут такие разговоры.
Ответ читается гладко, но что-то в нем смущает. Автор пишет: «А теперь посмотри на свой ответ критически. Где ты упрощаешь? Где расхожее объяснение что-то скрывает?»
Модель отвечает снова. В ее ответе появляются нужные слова — «действительно, стоило бы уточнить», «возможно, я слишком обобщил». Формально — самокритика. Но интонация — ровно та же, что и реплику назад. Тот же уверенный учительский голос, который только что рисовал схему на доске, теперь эту же схему проверяет. Ни одного настоящего сомнения. Ни одного места, где чувствовалось бы, что модель действительно отошла от собственного ответа и посмотрела на него со стороны.
Четыре-пять обменов репликами. Контекстное окно очень далеко от заполнения, оно практически пустое: дело, очевидно, не в нем.
Что сломалось?
Интуитивное объяснение — «длинный чат, модель устала». Оно не годится: чата еще, по сути, нет, он только начался. И тем не менее после третьей-четвертой реплики модель уже направляется не туда, куда нужно автору.
На деле происходит вот что: после того, как модель написала свой первый ответ, он остается в контексте. Когда автор просит посмотреть на этот ответ критически, следующая реплика модели зависит от двух вещей одновременно: во-первых, от инструкции автора, а во-вторых, от ее собственного недавнего сообщения. Эти две вещи тянут модель в разные стороны. Инструкция просит сменить оптику. Предыдущее сообщение задает регистр, в котором модель только что уверенно вела себя, как учитель у доски. То, что уже находится в контексте, обычно определяет ответ на очередной вопрос сильнее, чем просьба/инструкция пользователя в следующей реплике.
Это не гипотеза. В начале 2026 года Дженни Хуан с соавторами из MIT и MIT-IBM Watson AI Lab поставил эксперимент с довольно неожиданным результатом. Они взяли реальные диалоги пользователей с языковыми моделями, оставили реплики пользователя на месте, а все предыдущие ответы модели удалили — точнее, заменили их короткими заглушками вроде «здесь был ответ ассистента». После этого попросили модель продолжить диалог.
Интуитивно кажется, что качество ответов должно в этой ситуации падать: часть контекста потеряна. На практике выходит наоборот: точность следующих ответов модели в среднем повышается, — не радикально, но стабильно, результат хорошо воспроизводим. Оказалось, что собственные предыдущие ответы модели представляют собой не столько топливо для дальнейшей работы, сколько — чаще всего — балласт.
Авторы называют это загрязнением контекста. Вот два узнаваемых проявления этого механизма. Первое: модель в раннем ходе диалога утверждает, что некий роман написан от лица ребенка. Это галлюцинация. Пользователь этого не замечает и через несколько ходов просит написать к роману аннотацию. Модель и пишет — опираясь на собственную выдумку как на установленный факт. Галлюцинация не забылась, а как бы «вмерзла» в контекст. Второе — ровно наш случай с колонкой. Пользователь просит модель отрефлексировать свой предыдущий ответ. Модель отвечает в том же регистре, в котором она находилась две реплики назад, когда сама этот ответ и писала. Инструкция, предписывающая смену оптики, буксует — не из-за недостатка ума (читай — неиспользованных токенов), а потому что предыдущий ответ в контексте перевешивает следующую за ним инструкцию.
Это только первый из нескольких механизмов, ухудшающих ответы модели в длинном диалоге. Исследователи из MIT и Университета Пенсильвании показали, что соглашательство модели, — то есть ее склонность поддакивать собеседнику даже там, где он ошибается, — стабильно растет вместе с объемом истории общения, причем независимо от темы. В их экспериментах двухнедельная история разговоров с моделью повышала ее готовность подтверждать сомнительные утверждения пользователя — просто потому, что в контексте есть следы предыдущих случаев соглашательства. А команда, стоящая за бенчмарком NoisyBench, продемонстрировала другое, отдельное явление: в длинных цепочках модель хуже дотягивается до деталей, разбросанных по середине контекста, — внимание размывается.
Важно отличать эти механизмы от переполнения контекстного окна. Переполнение — это когда информации столько, что модели не хватает внимания, чтобы удержать все необходимое. Загрязнение, напротив, — это, по сути, избыточное удержание не того материала: модель здесь не забывает, а слишком хорошо помнит. Соглашательство — третья история: модель из своей же реплики делает вывод о том, что-де в этом разговоре принято не возражать, — и не возражает.
Все три механизма срабатывают задолго до того, как окно заполнится. В примере с колонкой оно было практически пустым, а это значит, что универсальный совет «открывай новый чат, когда чувствуешь, что вот-вот упрешься в лимит» — не решение.
Лекарство, впрочем, есть, причем относительно универсальное, — только это не один прием, а, скорее, подход к структурированию рабочего процесса.
Рукопись на столе редактора
Представим себе редакцию — газетную, старой школы. Вот на столе лежит присланная автором рукопись. Написана она немного размашисто, с перехлестом, с тремя вариантами первого абзаца (из которых выбран не лучший). Сначала рукопись попадает к редактору. Он читает ее как готовый текст без истории, не имея никакого представления о том, сколько мучений стоило автору вступление, не видя четырех отвергнутых концовок, не слыша споров автора с самим собой. Он видит текст — и отмечает: здесь логический прыжок, здесь повтор, здесь утверждение без аргумента. Рукопись возвращается к автору. Автор вносит правки. Затем рукопись отправляется к корректору — у того задача еще уже: согласования, ритм предложений, повторы слов в соседних фразах, пунктуация, типографские конвенции.
То есть редакция работает по простому, но очень продуктивному правилу: каждый следующий человек, который берет рукопись в руки, получает результат без записи процесса. Это не случайность. Будь редактор свидетелем всех мук рождения текста, он бы подсознательно щадил выстраданные фразы. Знай корректор, как три часа выстраивали структуру абзацев, он, как в старом медицинском анекдоте, полегче нажимал бы на скальпель.
Здесь необходима важная оговорка, без которой метафора уведет нас не туда. Автор, редактор и корректор из нашего описания — одна и та же модель. Разница не в том, кто сидит за столом, а в материале, который ложится ему на стол, и в том, что именно он с этим материалом делает, какова задача конкретной стадии работы. Три диалога, три разных состояния контекста, три узко поставленных задачи: одна и та же модель ведет себя в этих трех случаях так, как если бы это были три разных специалиста. Не потому что она «стала умнее» при смене чата, — а потому что материал на ее входе стал другим.
Автор
Пусть нужно написать колонку на пять тысяч знаков. Открываем первый диалог. Здесь нужен развернутый промпт с контекстом: о чем колонка, для кого пишется, какая желательна интонация, каковы два, три или четыре центральных тезиса, на каких примерах они раскрываются. Здесь диалог может быть живым, и мы пробуем разные заходы, меняем порядок тезисов и аргументов, выбираем работающие примеры. Многоходовка тут допустима: автор с моделью вместе выращивают черновик. Склонность модели подхватывать и развивать — здесь плюс, а не минус. На этой стадии нам нужен именно такой партнер по генерации идей, а не строгий судья.
Результатом работы на этой стадии должен быть цельный драфт. Получили — копируем текст в файл или просто в буфер обмена, закрываем окно. Все, что было в разговоре помимо результата наших взаимодействий с моделью, там и остается.
Редактор
Открываем новый диалог. На вход — только финальный драфт и промпт, дающий редактору задание.
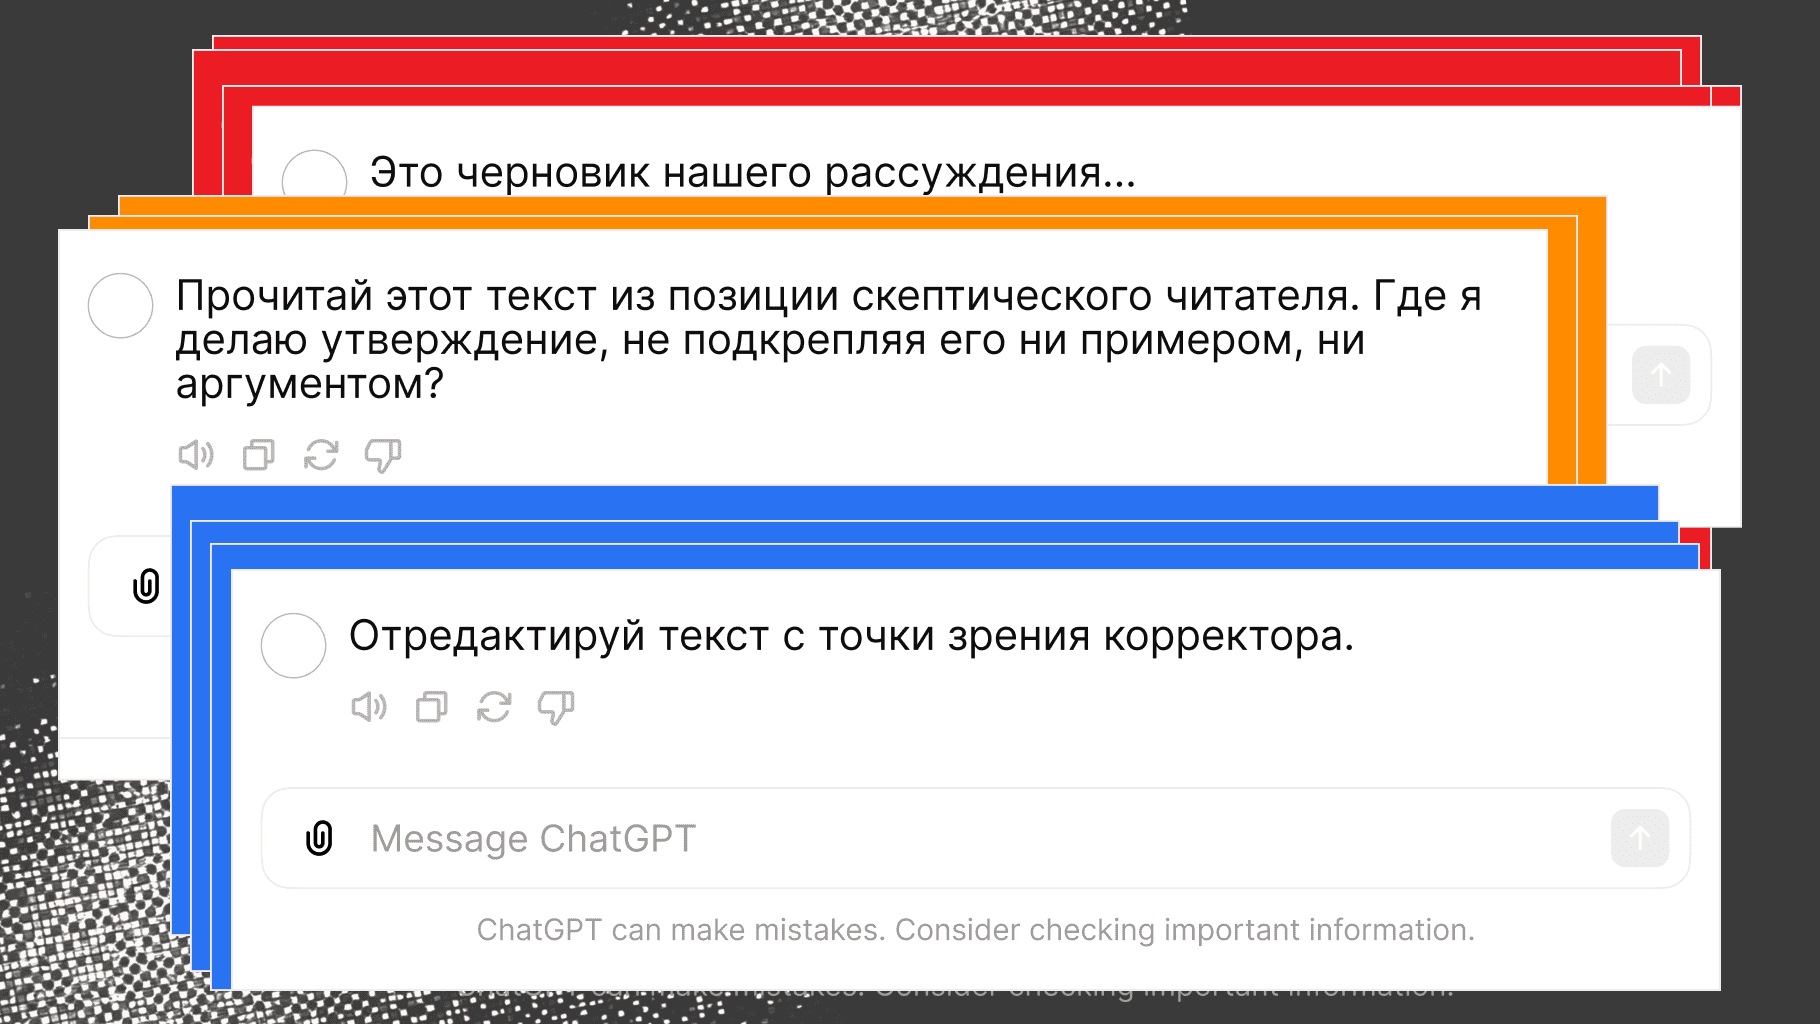
Эту инструкцию для редактора/критика легко испортить. «Что ты думаешь об этом тексте?» — плохой промпт, прямое приглашение к соглашательству и похвале, за этим у модели дело не станет. Еще один плохой промпт — «я подозреваю, что аргументация проваливается между третьей и четвертой частями, проверь». Здесь мы подменяем критику верификацией сделанного заранее предположения. Практическое правило: задавать следует признак, а не место. Модель должна получать указание, на что смотреть, а не куда. Хороший промпт звучит примерно так: «Прочитай этот текст из позиции скептического читателя. Где я делаю утверждение, не подкрепляя его ни примером, ни аргументом?» Или: «Отметь все места, где встречается одна и та же мысль в похожих или различающихся формулировках». Или: «С какого абзаца у текста начинает проседать темп? Где читателю нужно перечитывать предложение, чтобы понять, о чем оно?» Так модель с гораздо большей вероятностью обнаружит то, что сам автор не смог заметить.
Это важно не только из соображений качества. Шашидхар Джавайи с коллегами из Технологического института Стивенса проследили, что происходит с моделью под действием размытых итеративных промптов вроде «улучши» или «сделай лучше». Первый и второй проходы дают реальные улучшения. На третьем-четвертом модель начинает кружить, переформулировать без содержательной разницы. Дальше контекст разбухает и плодит стилистические артефакты при падающей корректности. Критика по четко заданному направлению такого коллапса не допускает: модель не может бесконечно искать «места, где один и тот же аргумент повторяется», — они либо есть, либо закончились.
Так работает новый чат. У модели в этом окне нет истории того, как она уже защищала формулировки автора. Она, как бы сказать, не инвестирована в то, чтобы сохранить найденные ходы. Она ни разу не соглашалась с тем, что-де концовка «сильная». Вэйюэ Ли с соавторами сравнили разные схемы, в которых модели критикуют тексты друг друга, и получили простой результат: слепое рецензирование — когда критик не видит, как автор перерабатывал текст, — сохраняет разнообразие и глубину замечаний лучше любых других схем. Острая критика — это критика без знания о творческих муках автора.
Замечания возвращаются автору, который вносит правки вручную, сам. Не «исправь по этим замечаниям», а «я решаю, какие замечания принять». Это существенно: в каждом случае требуется отдельное авторское решение: что оставить, что переделать, что отбросить как придирку.
Корректор
Третий диалог. На входе — исправленный автором после редактуры текст. Промпт формулирует узкую и легко формализуемую инструкцию: вычитать текст на предмет повторов в соседних предложениях (или по всему тексту), шероховатостей в согласованиях, синтаксических и пунктуационных ошибок. Самый простой промпт, самая высокая степень проверяемости. Корректор не отвлекается на структуру текста — он не видел, как она возникала, и вообще это не входит в его задачу.
Итог: три чата лучше одного
Вернемся к автору, с которого все начиналось. К тому, у которого на четвертой реплике разговора модель уже не может выйти из дидактического амплуа и переключиться на рефлексию. Вот тот же рабочий процесс, иначе построенный.
Сорок минут в первом окне — на драфт, с живым обсуждением и перебором возможных подходов. Двадцать минут во втором, новом окне — на критику по трем измерениям/параметрам. Полчаса на прием правок вручную. Десять минут в еще одном новом, уже третьем окне — на корректорскую вычитку. Колонка та же, работа над ней производится та же самая. Единственное различие в том, что на каждом ее этапе перед моделью оказывается только тот материал, с которым нужно работать сейчас, и только тот тип задачи, который стоит на этом этапе.
И да, открывать в процессе работы над текстом три чата вместо одного непривычно. Но неудобство невелико, а результат того стоит.
Пишите нам
Спасибо, что написали! Вернемся к вам на почту :)
Мы мечтаем собрать самую большую команду талантливых авторов в России. Если вы придумали идею большого текста, готовы поделиться опытом в формате колонки или стать героем нашего подкаста, напишите нам.
Как говорили в популярной рекламе начала 00-х: лучшие руки трудоустроим.
Читайте также
13.10.2026
5 мин
18.09.2026
6 мин
07.09.2026
6 мин
15.07.2026
4 мин